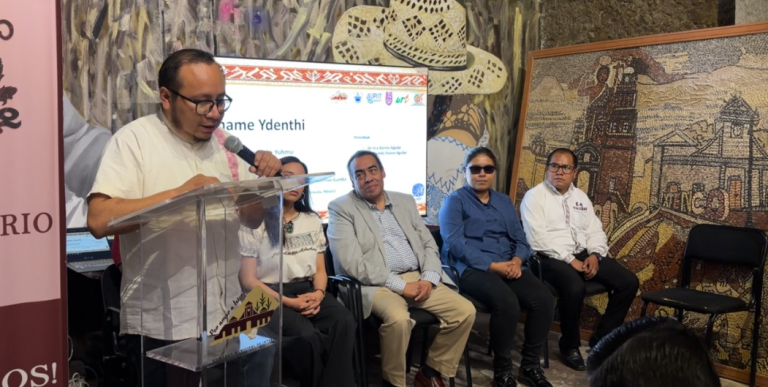
- La herramienta integra más de 8 mil palabras recopiladas durante un proceso de investigación y desarrollo, y busca facilitar la consulta, difusión y preservación de esta lengua originaria de Ixtenco, Tlaxcala, considerada en alto peligro de extinción.
Tlaxcala, Tlax.- El Colectivo Gumba presentó Hmame Ydenthi, un traductor automático que permite traducir del español a la lengua indígena Yuhmu y viceversa, mediante modelos de Inteligencia Artificial (IA) y un diccionario de palabras y frases.
En entrevista con Escenario Tlaxcala, Ricardo y Eric Ramos, doctores en Ingeniería del Lenguaje y del Conocimiento, explicaron que la herramienta es resultado de un proceso que combina documentación histórica, recopilación de vocabulario y registros de audio de hablantes nativos. Entre las aportaciones destaca la colaboración del maestro Mateo Cajero, cuyos conocimientos contribuyeron a integrar el material lingüístico utilizado en un primer proyecto.
Los investigadores detallaron que el desarrollo de esta tecnología implicó enfrentar algunos retos, principalmente por la escasez de datos digitales disponibles sobre el Yuhmu. Esta limitación representó un desafío para construir una herramienta de traducción automática, al tratarse de una lengua con pocos recursos lingüísticos digitalizados.
Durante la conversación también abordaron los cuestionamientos que suelen surgir sobre la investigación de lenguas indígenas frente a otros campos de estudio. Al respecto, plantearon la importancia de desarrollar este tipo de proyectos y de reconocer el valor de generar conocimiento y herramientas tecnológicas para idiomas que históricamente han contado con menos recursos para su documentación y difusión.
El desarrollo tecnológico «detrás de la magia» del traductor
Ricardo Ramos explicó que el desarrollo del traductor automático requirió construir una base de conocimiento con más de 8 mil palabras en formato escrito y registros de voz de 22 hablantes nativos, con cerca de 8 mil 600 términos asociados a su pronunciación.
Detalló que la preparación y limpieza de esta base de conocimiento tomó entre cuatro y cinco meses. Posteriormente, el equipo dedicó entre uno y dos meses al entrenamiento y ajuste de los modelos de Inteligencia Artificial mediante pruebas sucesivas, antes de integrar el sistema en la plataforma web del traductor.
Sin embargo, uno de los principales retos fue la escasez de datos digitales disponibles sobre el Yuhmu. Eric Ramos explicó que las herramientas computacionales requieren grandes cantidades de información para su desarrollo, por lo que la limitada documentación digitalizada de esta lengua representó una dificultad inicial para construir el sistema.
«Un reto muy grande que nosotros nos encontramos fue la falta de datos digitales, porque en un inicio el desarrollo de herramientas computacionales que son muy amplias requerían una gran cantidad de datos»
A diferencia de idiomas como el náhuatl o el maya, que cuentan con una mayor cantidad de información digital y documental, el Yuhmu dispone de menos recursos tecnológicos y lingüísticos. A ello se suma la diversidad de pronunciaciones y variaciones en algunas palabras entre sus hablantes, una característica que los investigadores reconocieron como parte de la propia diversidad de la lengua y no como un impedimento para continuar con el proyecto.
Años de investigación para documentar la lengua Yuhmu
De acuerdo con el Dr. Ricardo Ramos, el desarrollo del traductor automático es resultado de varios años de trabajo que integran investigación histórica, lingüística y computacional. Explicó que el análisis computacional de la lengua Yuhmu comenzó formalmente en 2018, a partir de investigaciones y prototipos que permitieron avanzar hacia la herramienta presentada por el Colectivo Gumba.
Por su parte, Eric Ramos explicó que una de las primeras etapas consistió en la documentación histórica y lingüística de la lengua, proceso en el que destacó la colaboración de Mateo Cajero. A partir de sus aportaciones y del trabajo de recopilación documental fue posible consolidar un primer diccionario de Yuhmu, acompañado de un teclado y recursos de audio para facilitar la consulta y comprensión del idioma.
Ambos investigadores reconocieron que la recuperación de esta lengua también ha sido posible gracias al trabajo comunitario realizado durante muchos años e incluso décadas, mediante la recopilación manual de vocabulario y las grabaciones de hablantes nativos. En este sentido, expresaron su agradecimiento a las personas hablantes y colaboradoras que han participado en las distintas etapas del proyecto.
Del registro histórico al uso cotidiano de la lengua
Más allá de la traducción automática, los investigadores explicaron que el proyecto busca acercar el Yuhmu a distintos espacios de la vida cotidiana y reconocer su riqueza lingüística, histórica y cultural.
Entre las particularidades que destacaron se encuentra su carácter tonal, pues la entonación puede modificar el significado de una palabra. También señalaron la complejidad de sus sonidos, que incluyen tonos ascendentes y descendentes, así como vocales nasales.
A estas características se suma la diversidad de formas de escritura utilizadas en los registros históricos y lingüísticos de la comunidad, por lo que el desarrollo de herramientas digitales también representa un esfuerzo por reunir y facilitar la consulta de estos conocimientos.
«El trabajar con lenguas indígenas es demasiadamente cuestionado […] Aparte de considerar la revalorización de este tipo de lenguas y su revitalización, está la parte de poder desarrollar más componentes tecnológicos que se trabajen»
Para el Colectivo Gumba, la digitalización del idioma abre posibilidades para que la población de Ixtenco y otras personas interesadas puedan consultar y utilizar el Yuhmu de manera gratuita. Entre sus aplicaciones cotidianas se encuentra su uso en actividades escolares, la identificación de establecimientos comerciales, la elección de nombres y la consulta de vocabulario cuando los hablantes se encuentran fuera de su comunidad.
De esta manera, los desarrolladores buscan que la lengua no permanezca únicamente en documentos y registros históricos, sino que pueda incorporarse a nuevos espacios de comunicación, aprendizaje y transmisión cultural.
«Sentimos un gusto, tenemos marcada una identidad muy grande [sobre Ixtenco], [y] sobre todo del otomí, creo que desde hace un tiempo se ha venido reforzando un poco más»
Nuevos horizontes para la lengua Yuhmu
Entre los siguientes pasos del Colectivo Gumba se encuentra ampliar la difusión de las herramientas digitales, tanto del portal de consulta como del traductor automático, con el propósito de facilitar su acceso a la población.
Asimismo, los investigadores plantearon la importancia de fomentar el reconocimiento y orgullo por la cultura Yuhmu, así como generar conciencia sobre la situación de vulnerabilidad que enfrenta la lengua. Para fortalecer este trabajo, también contemplan incorporar a más personas e investigadores al colectivo y consolidar la colaboración académica con instituciones como la Universidad Tecnológica de Tlaxcala, el Instituto Politécnico Nacional (IPN) y la Benemérita Universidad Autónoma de Puebla (BUAP).
En cuanto al desarrollo tecnológico, uno de los objetivos es evolucionar el portal de consulta hacia una plataforma interactiva de enseñanza y aprendizaje autodidacta, con características similares a las aplicaciones Duolingo o Rosetta Stone.
A este proyecto se suma la elaboración de un libro digital e interactivo enfocado en la enseñanza de los sonidos del Yuhmu, basado en la guía del maestro Mateo Cajero. La propuesta contempla vincular sus contenidos con un repositorio de audios para que las personas puedan escuchar las pronunciaciones y practicar desde casa.
Finalmente, los desarrolladores prevén ampliar los recursos visuales y auditivos de la plataforma, incorporar más palabras de uso cotidiano con sus respectivas grabaciones y actualizar el teclado virtual adaptado a las formas de escritura utilizadas en la comunidad.
También te puede interesar: Estudiantes del CBTIS 03 presentan exposición de ofrendas en el MUVART